¿Qué es un Esquema de Estrella? Modelado Dimensional para Datamarts Analíticos
De archivos Excel caóticos a un Data Mart profesional. Acompaña el proceso técnico de transformar los datos abiertos del SII (2005-2023) mediante el modelo dimensional de Ralph Kimball. Descubre cómo un Star Schema en PostgreSQL permite resolver jerarquías geográficas complejas, gestionar datos imputados por algoritmos y convertir consultas imposibles en SQL simple y eficiente. Una guía práctica sobre ingeniería de datos, normalización vs. desnormalización y el valor de la idempotencia en pipelines ETL.
Un Sábado de Ocho Commits
El 26 de septiembre de 2025 hice ocho commits en un solo día. Era sábado. Llevaba semanas intentando entender qué forma debía tener la base de datos que almacenaría los datos del SII, y ese día todo empezó a tomar forma.
El problema era concreto: el SII publica sus datos en archivos Excel con 19 hojas cada uno (una por año, de 2005 a 2023). Cada hoja tiene columnas como Nombre Actividad, Nombre Subrubro, Región, Provincia, Comuna, Número de Empresas, Ventas (UF), Renta Neta (UF). Todo en un formato plano diseñado para que un humano lo lea, no para que una máquina lo consulte eficientemente.
Había intentado guardar los datos en una sola tabla ancha. region, provincia, comuna, actividad, subrubro, rubro, anio, ventas_uf, renta_neta_uf...todo junto. Las consultas funcionaban, pero eran feas: doce columnas de texto que se repetían millones de veces. El commit 29b73b5 del mismo día aún usa tablas raw_* planas como capa de staging. Fue el paso intermedio.
El commit 6e7a8d5 dice: "pipeline de star schema". Ese fue el momento en que adopté el modelo dimensional de Ralph Kimball, y no he mirado atrás. Esto es lo que aprendí.
El Modelo Dimensional: Hechos y Dimensiones
La idea es separar los datos en dos tipos de tablas:
::tip El vocabulario oficial del modelado dimensional (Ralph Kimball) llama a este diseño dimensional modeling. El término "star schema" describe la forma visual del diagrama: la tabla de hechos al centro rodeada de dimensiones. ::\n
Tabla de Hechos (Facts)
Contiene las métricas numéricas que quieres analizar: ventas, número de empresas, renta neta. Cada fila es una observación en la intersección de todas las dimensiones relevantes. Es la tabla más grande, pero solo almacena números y claves foráneas.
Tablas de Dimensiones
Contienen los atributos descriptivos que dan contexto a los hechos: ¿de qué año? ¿de qué actividad económica? ¿de qué lugar geográfico? Son tablas pequeñas, pero ricas en texto.
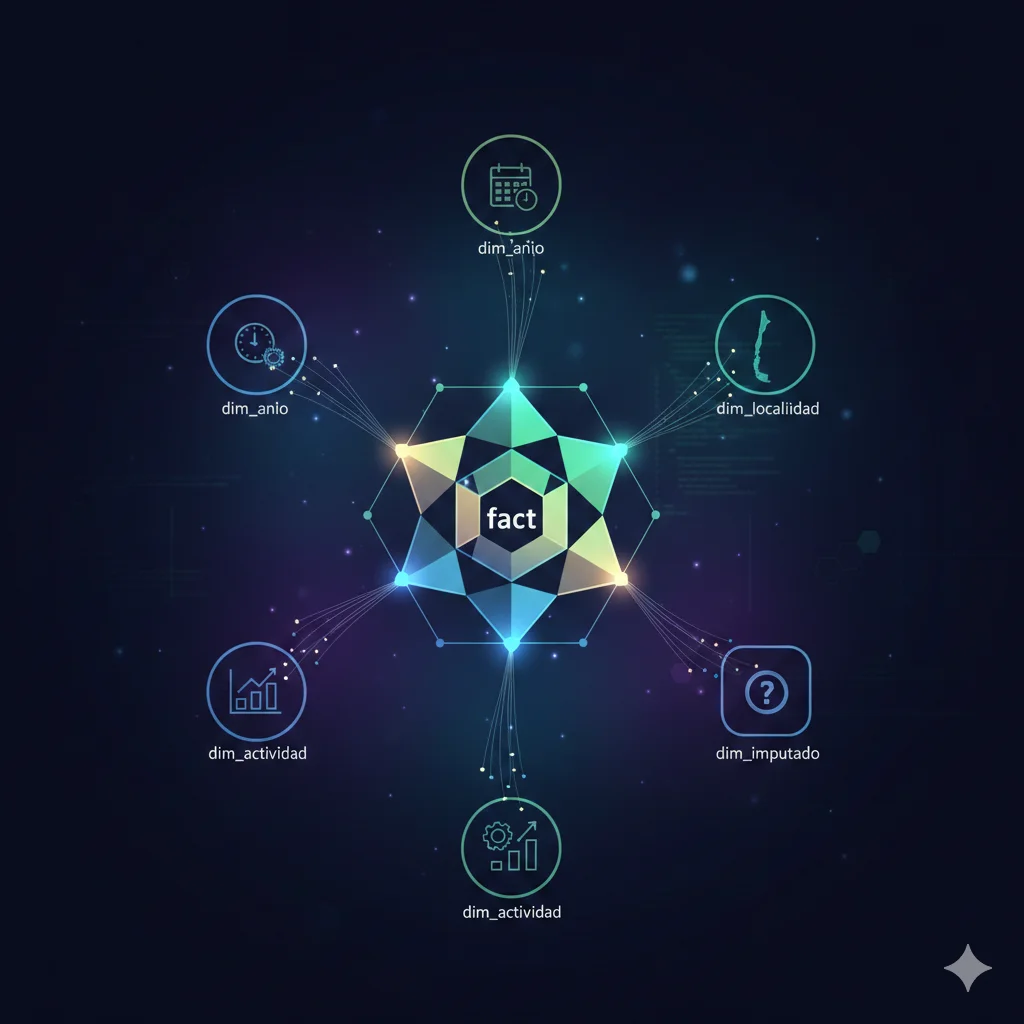
Cuando las tablas de dimensiones rodean a la tabla de hechos, el diagrama tiene forma de estrella:
            dim_anio
               |
               |
dim_actividad ─── fact_empresas ─── dim_localidad
               |
               |
          dim_imputado
De ahí el nombre: star schema.
::note
dim_imputado es la cuarta dimensión del esquema, agregada en v0.2.0 para resolver el problema de trazabilidad de los datos imputados por IPF. Sin esta dimensión, no habría forma de saber qué valores publicó el SII y cuáles estimó el algoritmo.
::
Un Ejemplo Concreto: dm_sii
En el proyecto manageDW, el esquema estrella para los datos del SII quedó así:
dim_anio — ¿Cuándo?
CREATE TABLE dim_anio (
  anio_id    SERIAL PRIMARY KEY,
  anio       INTEGER UNIQUE NOT NULL
);
COMMENT ON TABLE dim_anio IS 'Dimensión temporal - años 2005 a 2023';
Una fila por año. Parece trivial, pero permite agregar atributos temporales luego (trimestre fiscal, gobierno de turno, período de pandemia) sin modificar la tabla de hechos.
dim_actividad — ¿Qué sector?
CREATE TABLE dim_actividad (
  actividad_id    SERIAL PRIMARY KEY,
  actividad_cod   VARCHAR(10) UNIQUE NOT NULL,
  nombre          VARCHAR(300),
  subrubro_cod    VARCHAR(10),
  subrubro_nombre VARCHAR(300),
  rubro_cod       VARCHAR(10),
  rubro_nombre    VARCHAR(300)
);
COMMENT ON TABLE dim_actividad IS 'Jerarquía: rubro → subrubro → actividad';
Aquí reside una de las ventajas del modelo dimensional: la jerarquía económica (rubro → subrubro → actividad) queda desnormalizada dentro de la misma dimensión. En un modelo relacional normalizado (3NF), tendrías tres tablas separadas con foreign keys entre sí. En un star schema, todo está en una sola tabla.
¿Por qué? Porque las consultas analíticas hacen JOINs constantemente. Cada JOIN adicional tiene un costo. Si aplanar la jerarquía te ahorra un JOIN en cada consulta, y la tabla de dimensiones tiene solo miles de filas (no millones), el trade-off vale la pena.
dim_localidad — ¿Dónde?
CREATE TABLE dim_localidad (
  localidad_id   SERIAL PRIMARY KEY,
  nivel          VARCHAR(20) NOT NULL,   -- 'REGION', 'PROVINCIA', 'COMUNA'
  region_cod     VARCHAR(5),
  region_nombre  VARCHAR(100),
  provincia_cod  VARCHAR(5),
  provincia_nombre VARCHAR(100),
  comuna_cod     VARCHAR(10),
  comuna_nombre  VARCHAR(100)
);
COMMENT ON TABLE dim_localidad IS 'Jerarquía geográfica con 3 niveles';
El campo nivel es clave. El SII publica datos a tres escalas geográficas: región, provincia y comuna. En vez de tener tres tablas (una por nivel), usamos una sola dimensión con un discriminador. Esto simplifica enormemente las consultas:
-- Total de ventas por región, 2023
SELECT l.region_nombre, SUM(f.ventas_uf) as total_ventas
FROM fact_empresas f
JOIN dim_localidad l ON f.localidad_id = l.localidad_id
JOIN dim_anio a ON f.anio_id = a.anio_id
WHERE a.anio = 2023 AND l.nivel = 'REGION'
GROUP BY l.region_nombre
ORDER BY total_ventas DESC;
dim_imputado — ¿Es dato real o estimado?
CREATE TABLE dim_imputado (
  imputado_id  INTEGER PRIMARY KEY,
  estado       VARCHAR(20) NOT NULL,
  descripcion  TEXT
);
-- Solo 2 filas:
-- 0: 'original'  - Dato publicado por SII
-- 1: 'imputado'  - Estimado por IPF
Esta dimensión tiene solo dos filas, pero resuelve un problema de auditoría fundamental: ¿puedo confiar en este número? La tabla de hechos tiene columnas imputado_ventas_id e imputado_rentas_id que apuntan a esta dimensión. Si quiero análisis solo con datos reales, filtro por imputado_ventas_id = 0. Si quiero incluir los estimados, no filtro.
fact_empresas — La Tabla de Hechos
CREATE TABLE fact_empresas (
  fact_id        SERIAL PRIMARY KEY,
  anio_id        INTEGER REFERENCES dim_anio(anio_id),
  actividad_id   INTEGER REFERENCES dim_actividad(actividad_id),
  localidad_id   INTEGER REFERENCES dim_localidad(localidad_id),
  -- Métricas
  numero_empresas      INTEGER,
  ventas_uf            NUMERIC,
  renta_neta_uf        NUMERIC,
  trabajadores_dep     INTEGER,
  trabajadores_mujer   INTEGER,
  trabajadores_hombre  INTEGER,
  -- Trazabilidad de imputación (una columna por variable imputada)
  imputado_ventas_id      INTEGER DEFAULT 0 REFERENCES dim_imputado(imputado_id),
  imputado_renta_neta_id  INTEGER DEFAULT 0 REFERENCES dim_imputado(imputado_id)
);
::note
La convención de nombres es imputado_<var>_id, donde <var> es el nombre de la variable sin el sufijo _uf. La variable ventas_uf genera imputado_ventas_id; la variable renta_neta_uf genera imputado_renta_neta_id. El sistema crea estas columnas automáticamente según la lista variables_imputar.
:: Las métricas numéricas son aditivas: puedes sumarlas a lo largo de cualquier dimensión y el resultado tiene sentido. Esa propiedad es lo que hace poderoso al modelo dimensional.
::tip
La aditividad completa significa que no hay ambigüedad al agregar: SUM(ventas_uf) por región, por sector, por año, o cualquier combinación, siempre produce un resultado interpretable. Esto no ocurre con métricas calculadas como ratios o porcentajes.
::
¿Por Qué No una Tabla Normalizada (3NF)?
En un curso de bases de datos te enseñan normalización: eliminar redundancia, separar entidades, respetar formas normales. Un modelo 3NF para estos datos tendría unas 8-10 tablas con relaciones complejas entre sí:
region → provincia → comuna
rubro → subrubro → actividad
año
empresas (FK a año, FK a comuna, FK a actividad)
Cada consulta analítica requeriría 4-5 JOINs. El optimizador de PostgreSQL es bueno, pero no es mágico. Y más importante: el modelo 3NF está diseñado para aplicaciones transaccionales (OLTP) donde la prioridad es evitar anomalías de inserción/actualización. En un datamart analítico (OLAP), la prioridad es la velocidad de lectura.
El star schema sacrifica normalización a cambio de:
| Aspecto | 3NF (OLTP) | Star Schema (OLAP) |
|---|---|---|
| JOINs por consulta típica | 4-6 | 2-3 |
| Redundancia en dimensiones | Ninguna | Controlada (desnormalización intencional) |
| Velocidad de lectura | Buena | Excelente |
| Velocidad de escritura | Excelente | Buena |
| Facilidad de consulta | Requiere conocer el modelo | Intuitivo (hechos + contextos) |
| Tamaño en disco | Menor | Ligeramente mayor |
Para nuestro caso, la tabla de hechos tiene ~2 millones de filas. Las dimensiones tienen entre 2 y ~5.000 filas. La desnormalización de las dimensiones agrega quizás 1 MB de espacio. El ahorro en complejidad de consultas es enorme.
Códigos Jerárquicos: Un Patrón Útil
Los datos del SII usan nombres textuales para regiones, provincias y comunas. Los nombres cambian, tienen tildes inconsistentes, y a veces incluyen "Región de" y a veces no. Para evitar problemas, generamos códigos numéricos jerárquicos:
Región de Valparaíso      → region_cod = "05"
Provincia de Valparaíso   → provincia_cod = "0501"
Comuna de Valparaíso      → comuna_cod = "0501001"
La fórmula es determinista:
# En ETLStarSchemaSII
provincia_cod = paste0(region_cod, sprintf("%02d", secuencia_provincia))
comuna_cod    = paste0(provincia_cod, sprintf("%03d", secuencia_comuna))
Esto tiene una propiedad poderosa: dado un comuna_cod, puedes extraer su provincia y región con substr(). Es un esquema de codificación jerárquica que evita JOINs adicionales para resolver la geografía y que se usa extensamente en sistemas de clasificación territorial como NUTS en la Unión Europea o los códigos DANE en Colombia.
Upserts: Reejecutar Sin Miedo
Un pipeline ETL tiene que ser idempotente: ejecutarlo dos veces con los mismos datos debe producir el mismo resultado. PostgreSQL resuelve esto con ON CONFLICT ... DO UPDATE:
INSERT INTO dim_actividad (actividad_cod, nombre, subrubro_cod, ...)
SELECT * FROM tmp_actividad
ON CONFLICT (actividad_cod) DO UPDATE SET
  nombre = EXCLUDED.nombre,
  subrubro_cod = EXCLUDED.subrubro_cod;
Si la actividad ya existe, se actualiza. Si no existe, se inserta. Esto permite reejecutar el ETL completo sin limpiar la base primero. El patrón en R:
DBI::dbWithTransaction(self$con, {
  DBI::dbWriteTable(self$con, "tmp_actividad", self$dim_actividad,
                    temporary = TRUE, overwrite = TRUE)
  DBI::dbExecute(self$con, upsert_query)
})
La tabla temporal (tmp_actividad) existe solo durante la transacción. Si algo falla, PostgreSQL hace rollback y la base queda intacta.
Consultas Que Antes Eran Imposibles
Con el modelo estrella, las consultas analíticas se vuelven naturales:
Top 5 actividades por ventas en una región
SELECT a.nombre, SUM(f.ventas_uf) as total
FROM fact_empresas f
JOIN dim_actividad a ON f.actividad_id = a.actividad_id
JOIN dim_localidad l ON f.localidad_id = l.localidad_id
JOIN dim_anio y ON f.anio_id = y.anio_id
WHERE l.region_nombre = 'Metropolitana de Santiago'
  AND y.anio = 2023
  AND l.nivel = 'COMUNA'
GROUP BY a.nombre
ORDER BY total DESC
LIMIT 5;
Porcentaje de datos imputados por región
SELECT
  l.region_nombre,
  COUNT(*) as total_registros,
  SUM(CASE WHEN f.imputado_ventas_id = 1 THEN 1 ELSE 0 END) as imputados,
  ROUND(100.0 * SUM(CASE WHEN f.imputado_ventas_id = 1 THEN 1 ELSE 0 END)
        / COUNT(*), 1) as pct_imputado
FROM fact_empresas f
JOIN dim_localidad l ON f.localidad_id = l.localidad_id
WHERE l.nivel = 'COMUNA'
GROUP BY l.region_nombre
ORDER BY pct_imputado DESC;
::note
Filtrar por l.nivel = 'COMUNA' es esencial en esta consulta. Sin el filtro, la tabla incluye filas de región, provincia y comuna para la misma combinación económica, lo que triplicaría el conteo.
::
Evolución temporal de un sector
SELECT y.anio, SUM(f.ventas_uf) as ventas_total
FROM fact_empresas f
JOIN dim_anio y ON f.anio_id = y.anio_id
JOIN dim_actividad a ON f.actividad_id = a.actividad_id
JOIN dim_localidad l ON f.localidad_id = l.localidad_id
WHERE a.rubro_nombre LIKE '%Comercio%'
  AND l.nivel = 'REGION'
GROUP BY y.anio
ORDER BY y.anio;
Cada consulta tiene exactamente la misma estructura: fact → JOIN con las dimensiones relevantes → filtrar → agregar. Una vez que entiendes el patrón, puedes responder cualquier pregunta sobre los datos.
¿Cuándo Usar un Star Schema?
El modelo dimensional no es para todo. Es ideal cuando:
- Los datos son históricos y se acumulan (no se borran filas; se agregan nuevos períodos)
- Las consultas son analíticas (agregaciones, comparaciones, tendencias)
- Hay jerarquías naturales en los datos (geografía, clasificaciones económicas, tiempo)
- Necesitas trazabilidad (saber el origen de cada dato, como nuestra
dim_imputado) - Los usuarios finales son analistas, no desarrolladores de aplicaciones transaccionales
Si tus datos son un flujo de eventos en tiempo real, o si necesitas integridad referencial estricta con transacciones ACID de alta frecuencia, un modelo normalizado es mejor opción. Pero para un datamart analítico como el nuestro, el star schema es difícil de superar.
Reflexión
Cuando empecé este proyecto, los datos del SII estaban en 9 archivos Excel con 171 hojas. En el commit 29b73b5 del 26 de septiembre de 2025, aún los estaba cargando en tablas raw planas. En el commit 6e7a8d5 del mismo día, el esquema estrella apareció por primera vez.
La inversión de diseñar el esquema tomó unas horas ese sábado. El retorno ha sido constante: cada nueva pregunta analítica se responde con una consulta SQL simple, sin volver a tocar los archivos originales. Cuando en enero de 2026 agregué la dimensión dim_imputado para la trazabilidad del IPF, fue una tabla más con dos filas y una clave foránea. La arquitectura lo absorbió sin cambios en nada más.
Kimball publicó The Data Warehouse Toolkit en 1996. Treinta años después, su diseño sigue siendo la forma más pragmática de organizar datos para análisis.