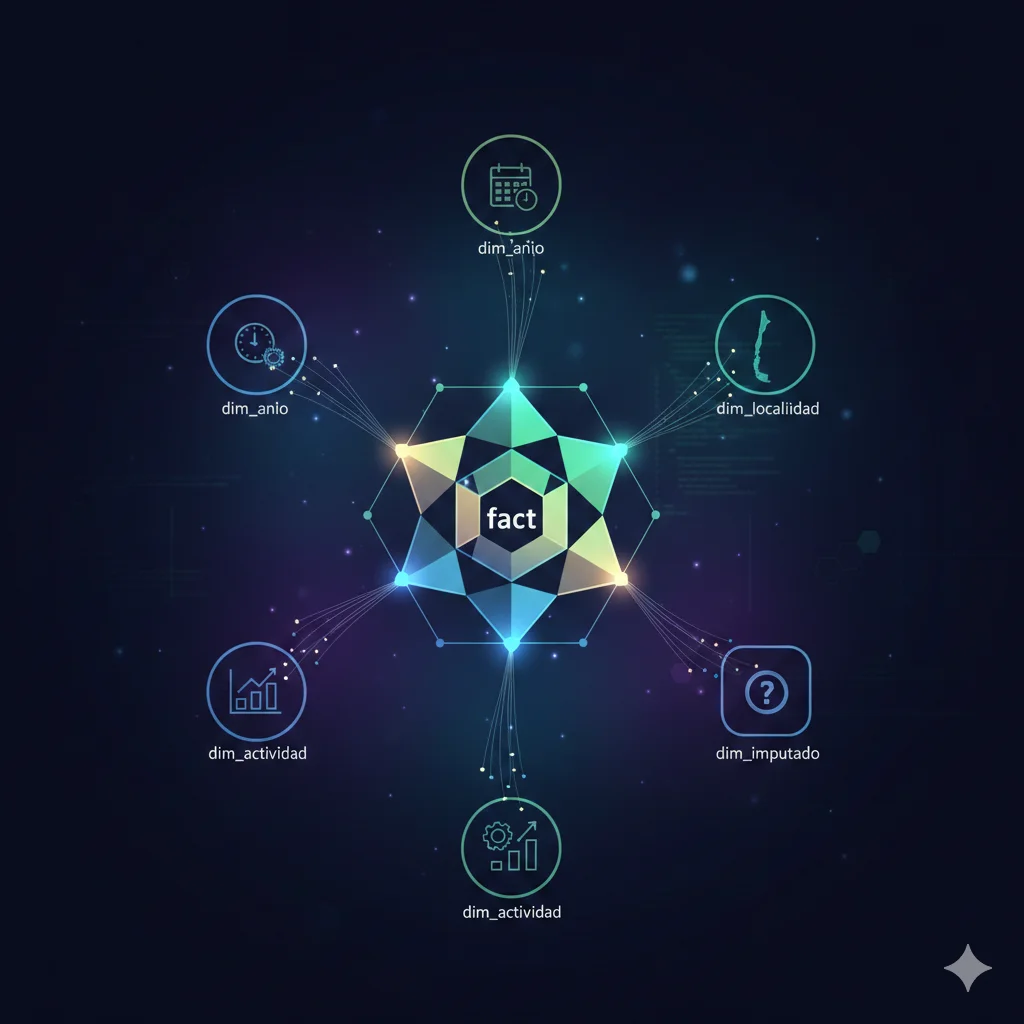
De archivos Excel caóticos a un Data Mart profesional. Acompaña el proceso técnico de transformar los datos abiertos del SII (2005-2023) mediante el modelo dimensional de Ralph Kimball. Descubre cómo un Star Schema en PostgreSQL permite resolver jerarquías geográficas complejas, gestionar datos imputados por algoritmos y convertir consultas imposibles en SQL simple y eficiente. Una guía práctica sobre ingeniería de datos, normalización vs. desnormalización y el valor de la idempotencia en pipelines ETL.
La base pública de precios hortofrutícolas de la Oficina de Estudios y Políticas Agrarias expone millones de registros a través de CKAN, pero descargarlos íntegramente exige lidiar con paginación estricta, cambios silenciosos en el esquema y unidades de venta inconsistentes. Este post muestra cómo construir un loader robusto con reintentos y caching, normalizar presentaciones heterogéneas a $/kg y transformar los datos crudos en un star schema analítico en PostgreSQL listo para consulta masiva.
La recuperación de un proyecto econométrico abandonado durante siete años obligó a pasar de scripts monolíticos y datos dispersos a una arquitectura reproducible: paquete R documentado, pipeline numerado con dependencias explícitas, base PostgreSQL en esquema estrella y validación tipo embudo para detectar fallos. El resultado no fue solo código más limpio, sino un sistema ejecutable con un comando, auditable y preparado para escalar. Una historia práctica sobre aplicar disciplina de ingeniería de software al código académico.