De scripts dispersos a una arquitectura profesional: La evolución de manageDW. Un análisis detallado sobre cómo la migración a un paquete de R y el uso del sistema de clases R6 transformaron un conjunto de funciones frágiles en un pipeline de datos robusto, escalable y fácil de mantener para el procesamiento de datos del SII.
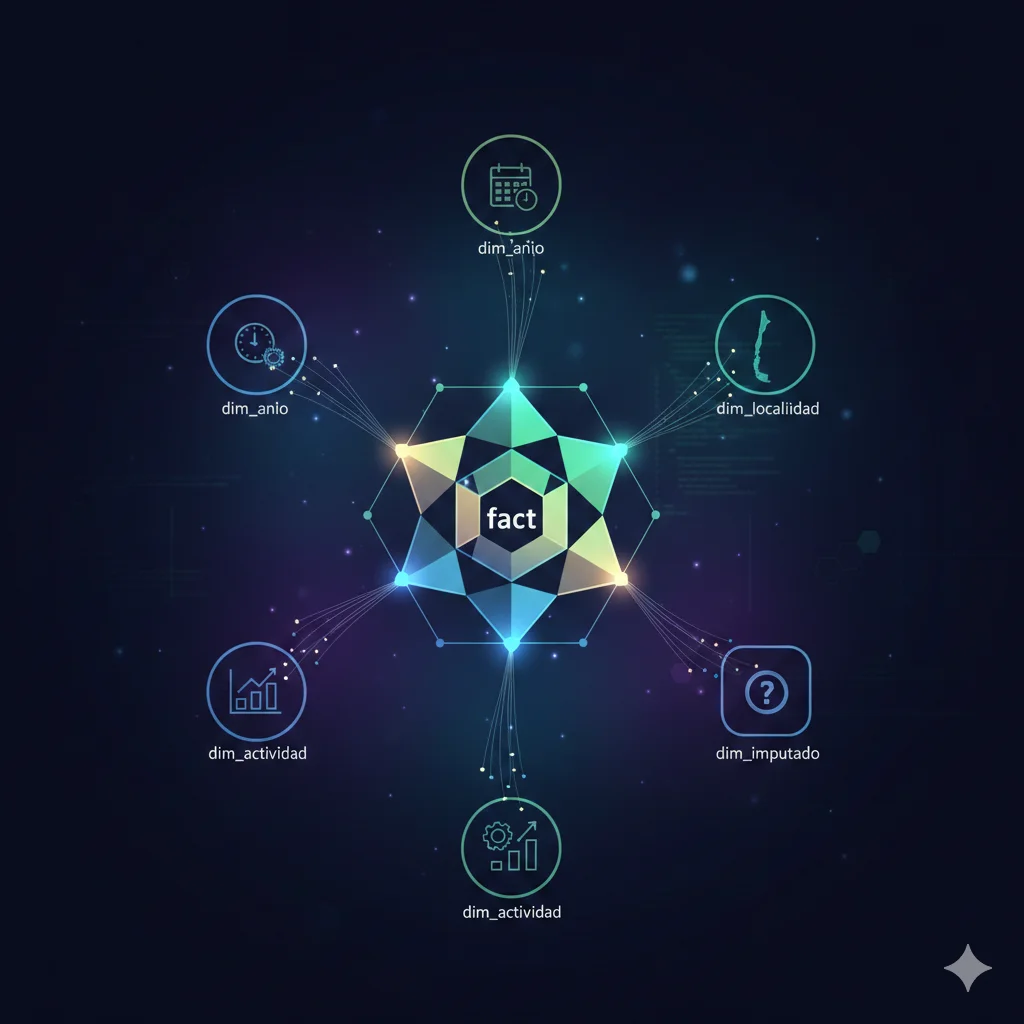
De archivos Excel caóticos a un Data Mart profesional. Acompaña el proceso técnico de transformar los datos abiertos del SII (2005-2023) mediante el modelo dimensional de Ralph Kimball. Descubre cómo un Star Schema en PostgreSQL permite resolver jerarquías geográficas complejas, gestionar datos imputados por algoritmos y convertir consultas imposibles en SQL simple y eficiente. Una guía práctica sobre ingeniería de datos, normalización vs. desnormalización y el valor de la idempotencia en pipelines ETL.
De Localhost al Mundo: Desplegando Shiny con Docker, Cloud Run y Neon.
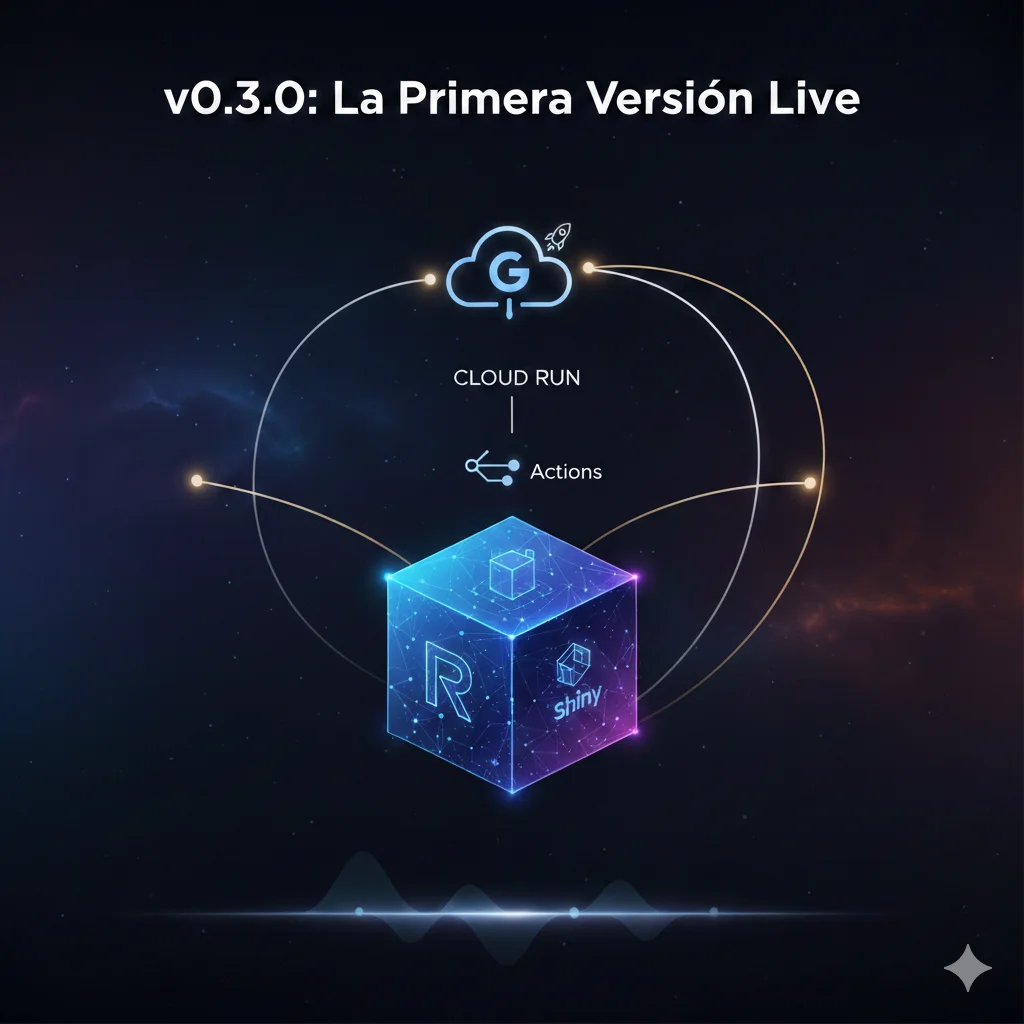
¿Cómo pasar un dashboard de R/Shiny de localhost a una URL pública con costo casi cero? En esta guía técnica de la v0.3.0, detallo la arquitectura serverless ideal para proyectos de datos: el uso de Neon para PostgreSQL escalable a cero, la contenedorización con Docker (optimizada para geo-dependencias) y el despliegue automatizado mediante GitHub Actions en Google Cloud Run. Una solución profesional para evitar los límites de shinyapps.io y la administración de servidores VPS.
¿Cómo lidiar con los datos censurados por confidencialidad en las estadísticas públicas? El SII de Chile utiliza asteriscos para proteger la privacidad en comunas con pocas empresas, rompiendo la coherencia jerárquica de los datos. En este post, exploramos cómo el proyecto manageDW resuelve este problema combinando la potencia predictiva de Random Forest con el rigor matemático del Iterative Proportional Fitting (IPF). Descubre cómo este algoritmo de 80 años de historia permite imputar valores faltantes asegurando que las sumas de las comunas coincidan exactamente con los totales provinciales y regionales.
¿Cómo pasar de 8 minutos a menos de 2 en un pipeline de datos con 171 hojas de Excel? En este post, analizo la migración crítica del proyecto manageDW desde dplyr hacia data.table. Exploro por qué la manipulación in-place y la gestión eficiente de memoria permitieron procesar 2 millones de filas reduciendo el consumo de RAM de 4 GB a solo 800 MB. Una comparativa técnica sobre cuándo priorizar la legibilidad de la "gramática de datos" frente al rendimiento bruto en entornos de producción.