Este artículo técnico describe la creación de un sistema ETL para extraer información de la API pública de arXiv, una fuente de publicaciones académicas. El objetivo es filtrar y analizar los papers más relevantes en áreas específicas. Se utiliza Python con bibliotecas como `requests` y `xml.etree.ElementTree` para la extracción, y Django para modelar los datos y exponer una API. El lector aprenderá sobre el diseño de un schema tipo fact table, el manejo de límites de la API, y la implementación de endpoints para acceder a los datos y estadísticas.
Este artículo describe la construcción de un pipeline de datos en R para monitorear un marketplace. El objetivo es extraer, normalizar y almacenar datos diarios de tendencias, productos y precios para análisis. Se utiliza R con las librerías `tidyverse`, `httr2`, `DBI` y clases R6 para estructurar el pipeline. El pipeline se despliega como un Cloud Run Job en Google Cloud Platform, utilizando OAuth 2.0 con rotación automática de tokens y garantizando la idempotencia mediante transacciones SQL. El lector aprenderá sobre la arquitectura del pipeline, la gestión de la autenticación, la persistenc
Este artículo técnico detalla la implementación del backend para un DataMart, resolviendo el problema de analizar datos de YouTube. Se utiliza Django para construir nueve modelos de datos, incluyendo tablas raw y dimensionales. Se implementa un ETL idempotente para evitar duplicados al procesar datos de la API de YouTube. El lector aprenderá sobre el diseño de modelos de datos, la creación de ETLs idempotentes y la construcción de endpoints para acceder a los datos procesados.
Este artículo describe el diseño de un DataMart para analizar datos de YouTube Analytics, resolviendo la limitación de la API al permitir el análisis histórico y de la competencia. Se utiliza la YouTube Data API v3, Django con JSONField para la capa raw y un esquema dimensional normalizado para las consultas analíticas. El lector aprenderá sobre la importancia de planificar la cuota de la API, diseñar un ETL idempotente y estructurar un DataMart en capas raw y dimensional antes de escribir el código.
¿Cómo pasar de 8 minutos a menos de 2 en un pipeline de datos con 171 hojas de Excel? En este post, analizo la migración crítica del proyecto manageDW desde dplyr hacia data.table. Exploro por qué la manipulación in-place y la gestión eficiente de memoria permitieron procesar 2 millones de filas reduciendo el consumo de RAM de 4 GB a solo 800 MB. Una comparativa técnica sobre cuándo priorizar la legibilidad de la "gramática de datos" frente al rendimiento bruto en entornos de producción.
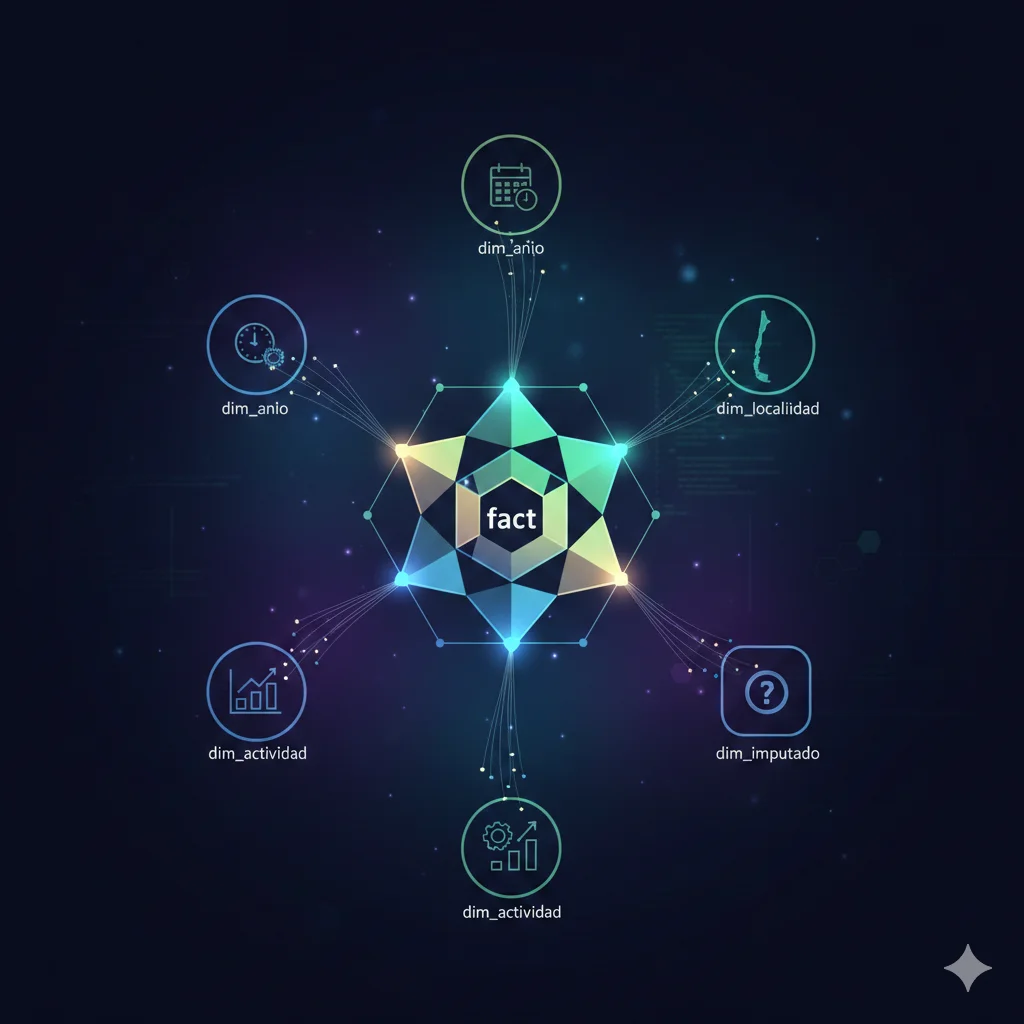
De archivos Excel caóticos a un Data Mart profesional. Acompaña el proceso técnico de transformar los datos abiertos del SII (2005-2023) mediante el modelo dimensional de Ralph Kimball. Descubre cómo un Star Schema en PostgreSQL permite resolver jerarquías geográficas complejas, gestionar datos imputados por algoritmos y convertir consultas imposibles en SQL simple y eficiente. Una guía práctica sobre ingeniería de datos, normalización vs. desnormalización y el valor de la idempotencia en pipelines ETL.
De scripts dispersos a una arquitectura profesional: La evolución de manageDW. Un análisis detallado sobre cómo la migración a un paquete de R y el uso del sistema de clases R6 transformaron un conjunto de funciones frágiles en un pipeline de datos robusto, escalable y fácil de mantener para el procesamiento de datos del SII.
La base pública de precios hortofrutícolas de la Oficina de Estudios y Políticas Agrarias expone millones de registros a través de CKAN, pero descargarlos íntegramente exige lidiar con paginación estricta, cambios silenciosos en el esquema y unidades de venta inconsistentes. Este post muestra cómo construir un loader robusto con reintentos y caching, normalizar presentaciones heterogéneas a $/kg y transformar los datos crudos en un star schema analítico en PostgreSQL listo para consulta masiva.