¿Cómo pasar de 8 minutos a menos de 2 en un pipeline de datos con 171 hojas de Excel? En este post, analizo la migración crítica del proyecto manageDW desde dplyr hacia data.table. Exploro por qué la manipulación in-place y la gestión eficiente de memoria permitieron procesar 2 millones de filas reduciendo el consumo de RAM de 4 GB a solo 800 MB. Una comparativa técnica sobre cuándo priorizar la legibilidad de la "gramática de datos" frente al rendimiento bruto en entornos de producción.
¿Cómo lidiar con los datos censurados por confidencialidad en las estadísticas públicas? El SII de Chile utiliza asteriscos para proteger la privacidad en comunas con pocas empresas, rompiendo la coherencia jerárquica de los datos. En este post, exploramos cómo el proyecto manageDW resuelve este problema combinando la potencia predictiva de Random Forest con el rigor matemático del Iterative Proportional Fitting (IPF). Descubre cómo este algoritmo de 80 años de historia permite imputar valores faltantes asegurando que las sumas de las comunas coincidan exactamente con los totales provinciales y regionales.
De Localhost al Mundo: Desplegando Shiny con Docker, Cloud Run y Neon.
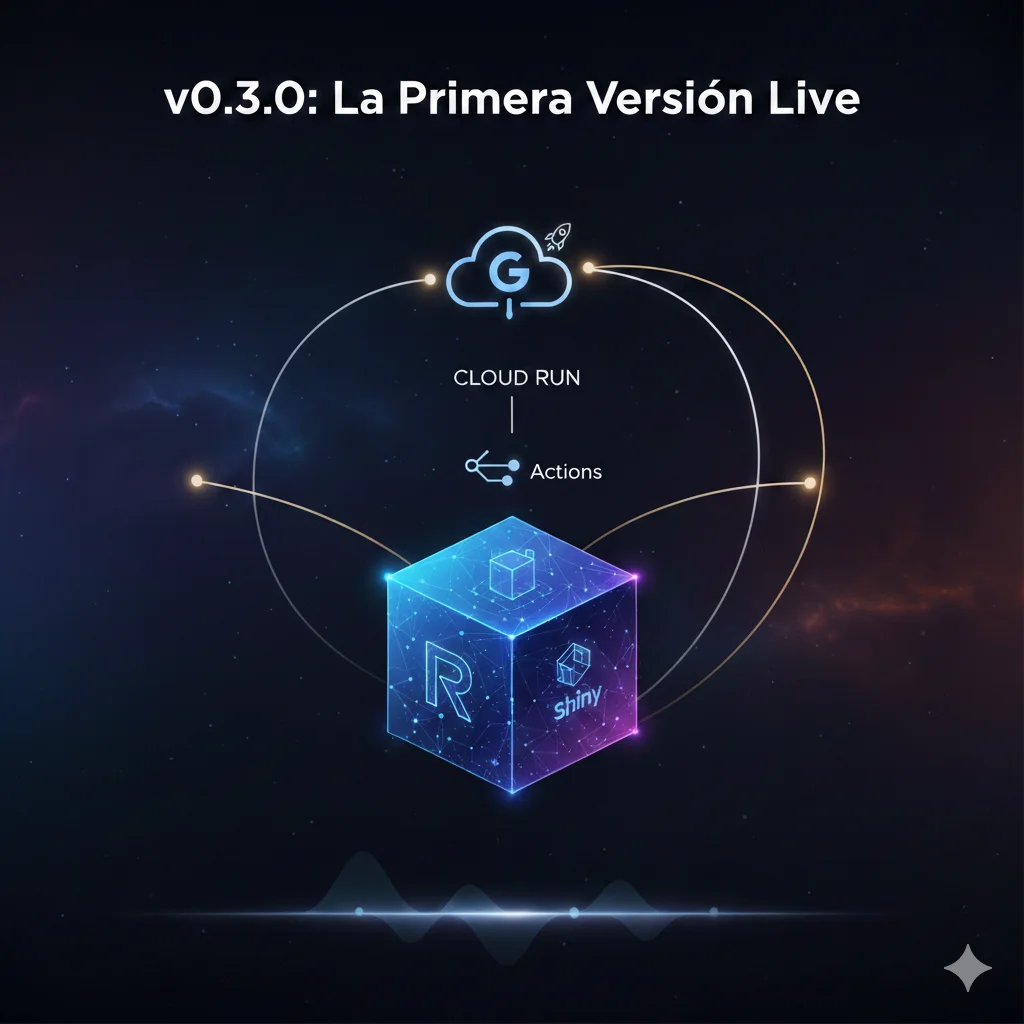
¿Cómo pasar un dashboard de R/Shiny de localhost a una URL pública con costo casi cero? En esta guía técnica de la v0.3.0, detallo la arquitectura serverless ideal para proyectos de datos: el uso de Neon para PostgreSQL escalable a cero, la contenedorización con Docker (optimizada para geo-dependencias) y el despliegue automatizado mediante GitHub Actions en Google Cloud Run. Una solución profesional para evitar los límites de shinyapps.io y la administración de servidores VPS.
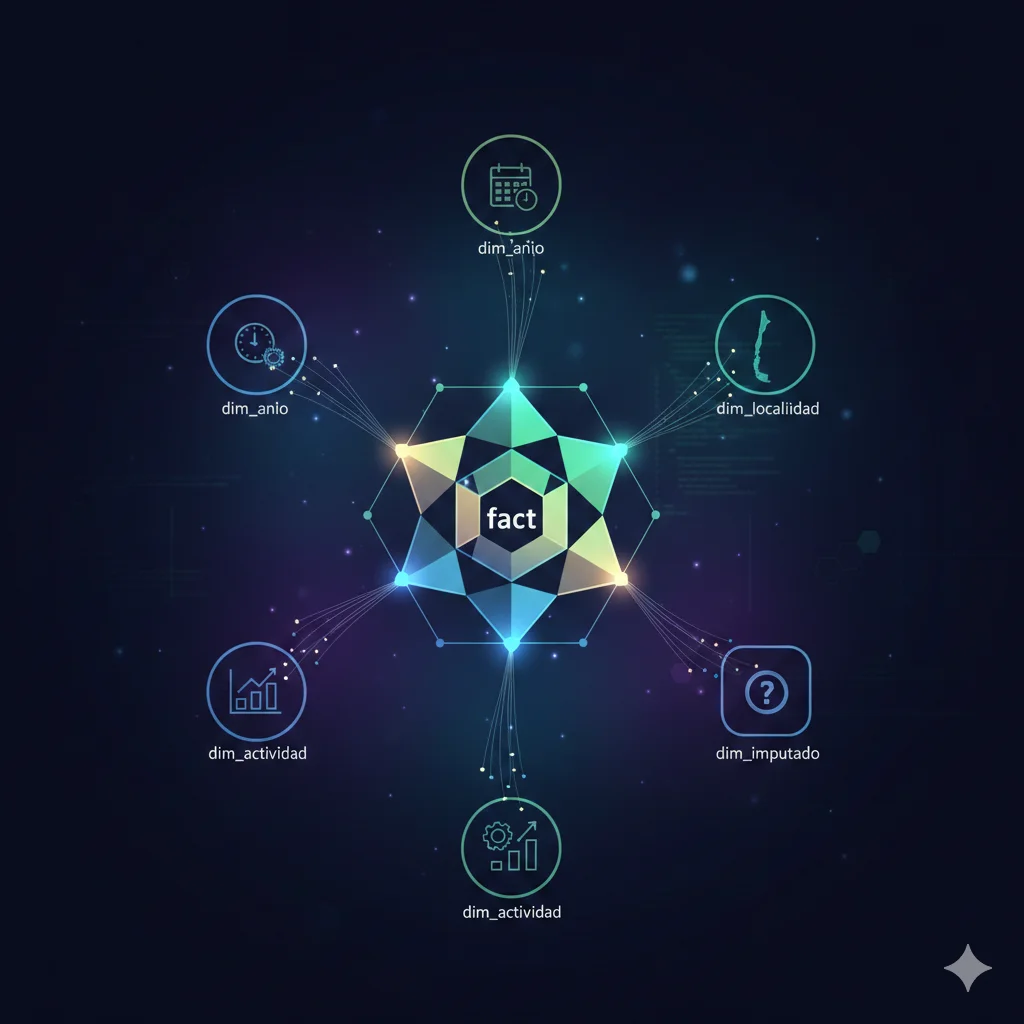
De archivos Excel caóticos a un Data Mart profesional. Acompaña el proceso técnico de transformar los datos abiertos del SII (2005-2023) mediante el modelo dimensional de Ralph Kimball. Descubre cómo un Star Schema en PostgreSQL permite resolver jerarquías geográficas complejas, gestionar datos imputados por algoritmos y convertir consultas imposibles en SQL simple y eficiente. Una guía práctica sobre ingeniería de datos, normalización vs. desnormalización y el valor de la idempotencia en pipelines ETL.
De scripts dispersos a una arquitectura profesional: La evolución de manageDW. Un análisis detallado sobre cómo la migración a un paquete de R y el uso del sistema de clases R6 transformaron un conjunto de funciones frágiles en un pipeline de datos robusto, escalable y fácil de mantener para el procesamiento de datos del SII.
Este post muestra cómo pasar de coeficientes econométricos a evidencia interpretable para política pública mediante analítica derivada pre-computada. El pipeline calcula estacionalidad de márgenes, estimaciones aproximadas de bienestar del consumidor basadas en GIRF, tests de robustez del umbral con Hansen-Seo y benchmarks cross-seccionales entre productos y regiones. Además, introduce un “embudo de validación” que verifica la integridad de cada etapa antes de generar reportes, junto con una decisión de arquitectura clave: separar completamente cálculo estadístico y presentación para lograr reportes reproducibles, rápidos y auditables.
El núcleo econométrico del pipeline se materializa en la estimación masiva de modelos TVECM por serie, seleccionados automáticamente tras diagnósticos de integración y cointegración. El proceso explora una malla de especificaciones en paralelo, selecciona la mejor por BIC y traduce los coeficientes en dinámicas interpretables mediante GIRF bootstrap, permitiendo cuantificar y clasificar asimetrías en la transmisión de precios. Los resultados se almacenan estructuradamente en PostgreSQL y alimentan reportes automatizados, cerrando el ciclo desde limpieza de datos hasta evidencia empírica reproducible.
Containerizar un proyecto de investigación no es solo una decisión técnica, sino metodológica: garantiza reproducibilidad, simplifica la colaboración y permite escalar cómputo sin fricción. Este post muestra cómo un pipeline econométrico intensivo se empaqueta con Docker, se orquesta localmente con PostgreSQL y se ejecuta como batch en Google Cloud mediante Cloud Run Jobs, con dependencias separadas por capas, secretos gestionados externamente y un entrypoint flexible para distintos modos de ejecución.
El problema no era el modelo TVECM: eran los datos. Varias series mostraban ajustes imposibles porque hasta un 60 % de sus valores provenían de imputación Kalman aplicada a la serie completa. En este post explico por qué los filtros globales fallan y cómo un enfoque por mes calendario —detectando meses razonables, formando islas de continuidad, filtrando por densidad real y aplicando Kalman solo dentro de segmentos confiables— reduce la imputación promedio de ~35 % a ~15 % y evita estimar dinámicas económicas sobre señal sintética. Una lección práctica de ingeniería de series temporales: la imputación solo debe cerrar huecos cortos, nunca reemplazar la información.
Un problema aparentemente trivial —emparejar el mismo producto entre precios mayoristas y minoristas de ODEPA— se convierte en un desafío real de integración de datos cuando no existen identificadores comunes y la nomenclatura difiere en granularidad, envases y variantes regionales. Este post muestra cómo un enfoque híbrido que combina normalización textual, embeddings semánticos multilingües y validación humana permitió aumentar en 55 % las series utilizables para estimar transmisión de precios, manteniendo una arquitectura R-Python desacoplada y reproducible.
La recuperación de un proyecto econométrico abandonado durante siete años obligó a pasar de scripts monolíticos y datos dispersos a una arquitectura reproducible: paquete R documentado, pipeline numerado con dependencias explícitas, base PostgreSQL en esquema estrella y validación tipo embudo para detectar fallos. El resultado no fue solo código más limpio, sino un sistema ejecutable con un comando, auditable y preparado para escalar. Una historia práctica sobre aplicar disciplina de ingeniería de software al código académico.