Este artículo describe cómo conectar un pipeline de datos con una aplicación Django existente para crear un dashboard de análisis. El pipeline escribe datos de tendencias y productos en una base de datos PostgreSQL separada. Se utiliza Django con `managed=False` y un `DatabaseRouter` para acceder a estos datos sin interferir con la base de datos principal de la aplicación. El frontend, construido con React, permite explorar los datos a través de varios endpoints y filtros interactivos, ofreciendo una interfaz para el análisis de mercado.
Este artículo describe la construcción de un pipeline de datos en R para monitorear un marketplace. El objetivo es extraer, normalizar y almacenar datos diarios de tendencias, productos y precios para análisis. Se utiliza R con las librerías `tidyverse`, `httr2`, `DBI` y clases R6 para estructurar el pipeline. El pipeline se despliega como un Cloud Run Job en Google Cloud Platform, utilizando OAuth 2.0 con rotación automática de tokens y garantizando la idempotencia mediante transacciones SQL. El lector aprenderá sobre la arquitectura del pipeline, la gestión de la autenticación, la persistenc
De Localhost al Mundo: Desplegando Shiny con Docker, Cloud Run y Neon.
¿Cómo pasar un dashboard de R/Shiny de localhost a una URL pública con costo casi cero? En esta guía técnica de la v0.3.0, detallo la arquitectura serverless ideal para proyectos de datos: el uso de Neon para PostgreSQL escalable a cero, la contenedorización con Docker (optimizada para geo-dependencias) y el despliegue automatizado mediante GitHub Actions en Google Cloud Run. Una solución profesional para evitar los límites de shinyapps.io y la administración de servidores VPS.
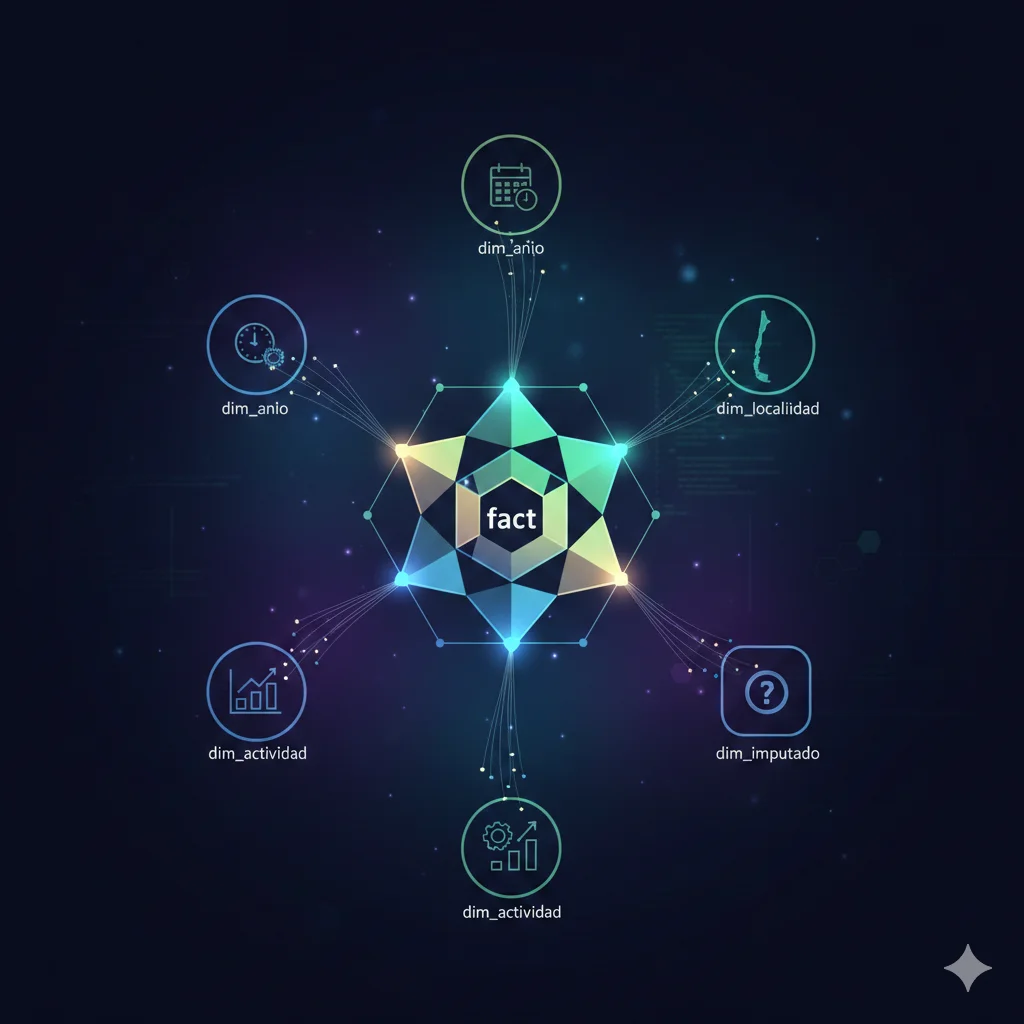
De archivos Excel caóticos a un Data Mart profesional. Acompaña el proceso técnico de transformar los datos abiertos del SII (2005-2023) mediante el modelo dimensional de Ralph Kimball. Descubre cómo un Star Schema en PostgreSQL permite resolver jerarquías geográficas complejas, gestionar datos imputados por algoritmos y convertir consultas imposibles en SQL simple y eficiente. Una guía práctica sobre ingeniería de datos, normalización vs. desnormalización y el valor de la idempotencia en pipelines ETL.
De scripts dispersos a una arquitectura profesional: La evolución de manageDW. Un análisis detallado sobre cómo la migración a un paquete de R y el uso del sistema de clases R6 transformaron un conjunto de funciones frágiles en un pipeline de datos robusto, escalable y fácil de mantener para el procesamiento de datos del SII.
Este post muestra cómo pasar de coeficientes econométricos a evidencia interpretable para política pública mediante analítica derivada pre-computada. El pipeline calcula estacionalidad de márgenes, estimaciones aproximadas de bienestar del consumidor basadas en GIRF, tests de robustez del umbral con Hansen-Seo y benchmarks cross-seccionales entre productos y regiones. Además, introduce un “embudo de validación” que verifica la integridad de cada etapa antes de generar reportes, junto con una decisión de arquitectura clave: separar completamente cálculo estadístico y presentación para lograr reportes reproducibles, rápidos y auditables.
El núcleo econométrico del pipeline se materializa en la estimación masiva de modelos TVECM por serie, seleccionados automáticamente tras diagnósticos de integración y cointegración. El proceso explora una malla de especificaciones en paralelo, selecciona la mejor por BIC y traduce los coeficientes en dinámicas interpretables mediante GIRF bootstrap, permitiendo cuantificar y clasificar asimetrías en la transmisión de precios. Los resultados se almacenan estructuradamente en PostgreSQL y alimentan reportes automatizados, cerrando el ciclo desde limpieza de datos hasta evidencia empírica reproducible.
Containerizar un proyecto de investigación no es solo una decisión técnica, sino metodológica: garantiza reproducibilidad, simplifica la colaboración y permite escalar cómputo sin fricción. Este post muestra cómo un pipeline econométrico intensivo se empaqueta con Docker, se orquesta localmente con PostgreSQL y se ejecuta como batch en Google Cloud mediante Cloud Run Jobs, con dependencias separadas por capas, secretos gestionados externamente y un entrypoint flexible para distintos modos de ejecución.
Un problema aparentemente trivial —emparejar el mismo producto entre precios mayoristas y minoristas de ODEPA— se convierte en un desafío real de integración de datos cuando no existen identificadores comunes y la nomenclatura difiere en granularidad, envases y variantes regionales. Este post muestra cómo un enfoque híbrido que combina normalización textual, embeddings semánticos multilingües y validación humana permitió aumentar en 55 % las series utilizables para estimar transmisión de precios, manteniendo una arquitectura R-Python desacoplada y reproducible.
La base pública de precios hortofrutícolas de la Oficina de Estudios y Políticas Agrarias expone millones de registros a través de CKAN, pero descargarlos íntegramente exige lidiar con paginación estricta, cambios silenciosos en el esquema y unidades de venta inconsistentes. Este post muestra cómo construir un loader robusto con reintentos y caching, normalizar presentaciones heterogéneas a $/kg y transformar los datos crudos en un star schema analítico en PostgreSQL listo para consulta masiva.
La recuperación de un proyecto econométrico abandonado durante siete años obligó a pasar de scripts monolíticos y datos dispersos a una arquitectura reproducible: paquete R documentado, pipeline numerado con dependencias explícitas, base PostgreSQL en esquema estrella y validación tipo embudo para detectar fallos. El resultado no fue solo código más limpio, sino un sistema ejecutable con un comando, auditable y preparado para escalar. Una historia práctica sobre aplicar disciplina de ingeniería de software al código académico.
Una tesis de magíster iniciada en 2017 para estudiar la transmisión asimétrica de precios en el mercado agrícola chileno terminó, ocho años después, convertida en un pipeline reproducible de software: paquete R, base PostgreSQL, matching semántico y ejecución en la nube. Este post cuenta la evolución técnica del proyecto —de scripts académicos a ingeniería de datos— y cómo hoy permite estimar modelos TVECM en decenas de series producto-región.
Este artículo detalla la migración de una base de datos PostgreSQL de Cloud SQL a Neon para reducir costos. Se explica cómo crear un proyecto en Neon, habilitar la extensión pgvector, exportar la base de datos de Cloud SQL usando `gcloud`, importarla a Neon con `psql`, y finalmente, actualizar la configuración de Cloud Run para apuntar a la nueva base de datos. El lector aprenderá a migrar bases de datos entre plataformas cloud y a optimizar costos de infraestructura.
Este artículo detalla el despliegue de una aplicación full-stack serverless en Google Cloud Platform. Se describe la arquitectura, que incluye un frontend React en Cloud Run, un backend Django con DRF también en Cloud Run, una base de datos PostgreSQL en Cloud SQL con pgvector, y Vertex AI para embeddings y generación de lenguaje. Aprenderás a configurar el proyecto en GCP, habilitar las APIs necesarias, configurar las credenciales y crear una instancia de PostgreSQL en Cloud SQL. Se explica la migración a Neon PostgreSQL serverless.
Este artículo técnico revela la verdad oculta sobre los costos de Cloud SQL, especialmente cuando se utiliza para proyectos pequeños. Explica cómo, a diferencia de servicios como Cloud Run, Vertex AI y Cloud Storage que cobran por uso, Cloud SQL cobra por la instancia activa 24/7, incluso si la base de datos está casi vacía. Se analiza el desglose de costos de cada servicio en Google Cloud y se explica por qué Cloud SQL puede ser una opción costosa para aplicaciones de bajo tráfico. El lector aprenderá a identificar cuándo Cloud SQL es la opción correcta y cuándo es mejor buscar alternativas m