Este artículo aborda la transformación de un blog personal en un portafolio profesional enfocado en data science y machine learning. Se describe cómo reestructurar la página principal (Home.js) para destacar habilidades, proyectos y experiencia relevante para reclutadores. Se discuten decisiones de diseño como la creación de una página `/projects` dedicada y la selección de proyectos clave. El lector aprenderá a priorizar la información, implementar un "hero section" con métricas verificables y mostrar un stack tecnológico visible, utilizando React y componentes MUI.
¿Cómo pasar de 8 minutos a menos de 2 en un pipeline de datos con 171 hojas de Excel? En este post, analizo la migración crítica del proyecto manageDW desde dplyr hacia data.table. Exploro por qué la manipulación in-place y la gestión eficiente de memoria permitieron procesar 2 millones de filas reduciendo el consumo de RAM de 4 GB a solo 800 MB. Una comparativa técnica sobre cuándo priorizar la legibilidad de la "gramática de datos" frente al rendimiento bruto en entornos de producción.
¿Cómo lidiar con los datos censurados por confidencialidad en las estadísticas públicas? El SII de Chile utiliza asteriscos para proteger la privacidad en comunas con pocas empresas, rompiendo la coherencia jerárquica de los datos. En este post, exploramos cómo el proyecto manageDW resuelve este problema combinando la potencia predictiva de Random Forest con el rigor matemático del Iterative Proportional Fitting (IPF). Descubre cómo este algoritmo de 80 años de historia permite imputar valores faltantes asegurando que las sumas de las comunas coincidan exactamente con los totales provinciales y regionales.
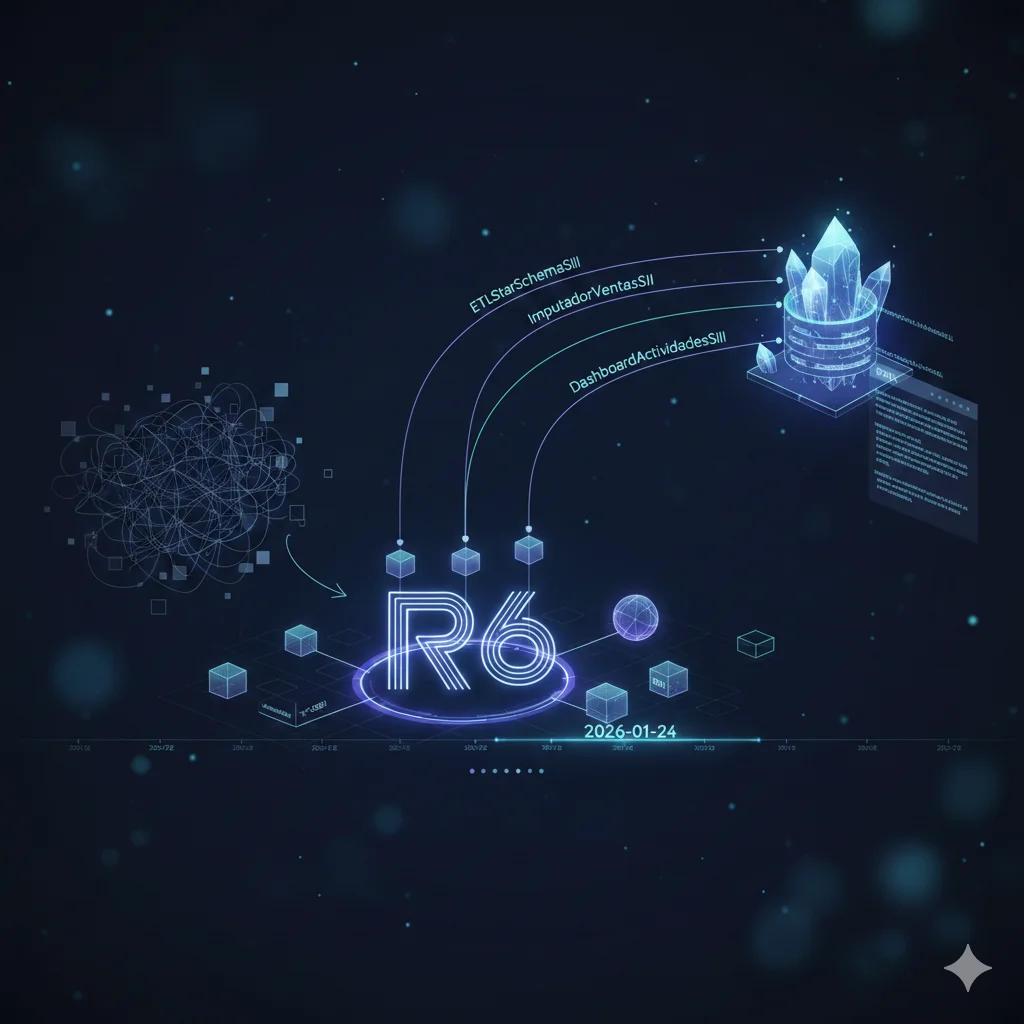
De scripts dispersos a una arquitectura profesional: La evolución de manageDW. Un análisis detallado sobre cómo la migración a un paquete de R y el uso del sistema de clases R6 transformaron un conjunto de funciones frágiles en un pipeline de datos robusto, escalable y fácil de mantener para el procesamiento de datos del SII.
Containerizar un proyecto de investigación no es solo una decisión técnica, sino metodológica: garantiza reproducibilidad, simplifica la colaboración y permite escalar cómputo sin fricción. Este post muestra cómo un pipeline econométrico intensivo se empaqueta con Docker, se orquesta localmente con PostgreSQL y se ejecuta como batch en Google Cloud mediante Cloud Run Jobs, con dependencias separadas por capas, secretos gestionados externamente y un entrypoint flexible para distintos modos de ejecución.