Este artículo técnico detalla el rediseño de un pipeline de scraping y matching de productos para resolver problemas de IDs inestables y falsos positivos. Se implementa una estrategia de IDs estables para evitar duplicados, se fusionan señales de texto con BM25 y cosine similarity usando RRF, y se introduce un sistema de Entity Resolution local basado en scoring de componentes (marca, modelo, tamaño, etc.). El pipeline automatizado, desplegado en Cloud Run Job, mejoró la precisión y redujo drásticamente el tiempo de ejecución. El lector aprenderá sobre la implementación de estas técnicas y su
Este artículo aborda el problema de desplegar cambios directamente a producción, introduciendo un entorno de staging para pruebas previas. Se implementa un pipeline CI/CD multi-ambiente con GitHub Actions y Cloud Run, gestionando las diferencias de configuración entre staging y producción. El lector aprenderá a configurar un workflow para desplegar a múltiples entornos, obtener dinámicamente URLs de servicios en Cloud Run y configurar CORS dinámicamente.
Este artículo técnico aborda el problema del "cold start" en una aplicación SPA (Single Page Application) desplegada en Cloud Run, donde la primera carga tras un período de inactividad es excesivamente lenta. Se identifican tres causas principales: el escalado a cero de Cloud Run, el bloqueo del renderizado por una llamada a la API y la falta de un mecanismo de "warm-up". Se implementan soluciones como mantener una instancia activa en Cloud Run, desacoplar el contenido estático del estado de carga y usar `--cpu-boost`. Aprenderás a optimizar el rendimiento de tu SPA y mejorar la experiencia de
Este artículo técnico detalla la resolución de cinco bugs críticos encontrados en el panel de administración de Django en un entorno de producción. El primer bug, un error 503, se debió a una señal sincrónica que bloqueaba Gunicorn al interactuar con Vertex AI. La solución implicó el uso de `transaction.on_commit()` y hilos daemon. El segundo bug, también un error 503, fue causado por un fallo en la verificación CSRF debido a un problema de parsing en GitHub Actions. Aprenderás sobre el manejo de señales en Django, la configuración de Gunicorn y la depuración de errores en entornos de producc
Este artículo detalla el proceso para configurar un dominio propio (`hectorgarrido.cl`) en Cloud Run, desde la compra del dominio en NIC Chile hasta la configuración del DNS. Aprenderás a crear una zona administrada en Cloud DNS, mapear el dominio a tu servicio de Cloud Run y actualizar los nameservers en el registrador del dominio. Se utiliza la herramienta `gcloud` para interactuar con Google Cloud y se explica la arquitectura DNS involucrada, permitiendo a los lectores tener control total sobre sus dominios y una integración fluida con Cloud Run.
De Localhost al Mundo: Desplegando Shiny con Docker, Cloud Run y Neon.
¿Cómo pasar un dashboard de R/Shiny de localhost a una URL pública con costo casi cero? En esta guía técnica de la v0.3.0, detallo la arquitectura serverless ideal para proyectos de datos: el uso de Neon para PostgreSQL escalable a cero, la contenedorización con Docker (optimizada para geo-dependencias) y el despliegue automatizado mediante GitHub Actions en Google Cloud Run. Una solución profesional para evitar los límites de shinyapps.io y la administración de servidores VPS.
Containerizar un proyecto de investigación no es solo una decisión técnica, sino metodológica: garantiza reproducibilidad, simplifica la colaboración y permite escalar cómputo sin fricción. Este post muestra cómo un pipeline econométrico intensivo se empaqueta con Docker, se orquesta localmente con PostgreSQL y se ejecuta como batch en Google Cloud mediante Cloud Run Jobs, con dependencias separadas por capas, secretos gestionados externamente y un entrypoint flexible para distintos modos de ejecución.
Este artículo detalla la migración de una base de datos PostgreSQL de Cloud SQL a Neon para reducir costos. Se explica cómo crear un proyecto en Neon, habilitar la extensión pgvector, exportar la base de datos de Cloud SQL usando `gcloud`, importarla a Neon con `psql`, y finalmente, actualizar la configuración de Cloud Run para apuntar a la nueva base de datos. El lector aprenderá a migrar bases de datos entre plataformas cloud y a optimizar costos de infraestructura.
Este artículo describe la migración de un motor RAG desde una arquitectura multi-proveedor (SBERT, Ollama y Vertex AI) a una solución exclusiva con Vertex AI, explicando las razones detrás de esta decisión y el refactor resultante. Además, aborda un problema intermitente de carga de datos en la página de inicio debido a cold starts de Cloud Run. La solución implementada involucra un mecanismo de retry con exponential backoff en el cliente API (JavaScript/Axios). Aprenderás sobre las ventajas de simplificar la arquitectura, el manejo de cold starts y la implementación de retries.
Este artículo detalla el despliegue de una aplicación full-stack serverless en Google Cloud Platform. Se describe la arquitectura, que incluye un frontend React en Cloud Run, un backend Django con DRF también en Cloud Run, una base de datos PostgreSQL en Cloud SQL con pgvector, y Vertex AI para embeddings y generación de lenguaje. Aprenderás a configurar el proyecto en GCP, habilitar las APIs necesarias, configurar las credenciales y crear una instancia de PostgreSQL en Cloud SQL. Se explica la migración a Neon PostgreSQL serverless.
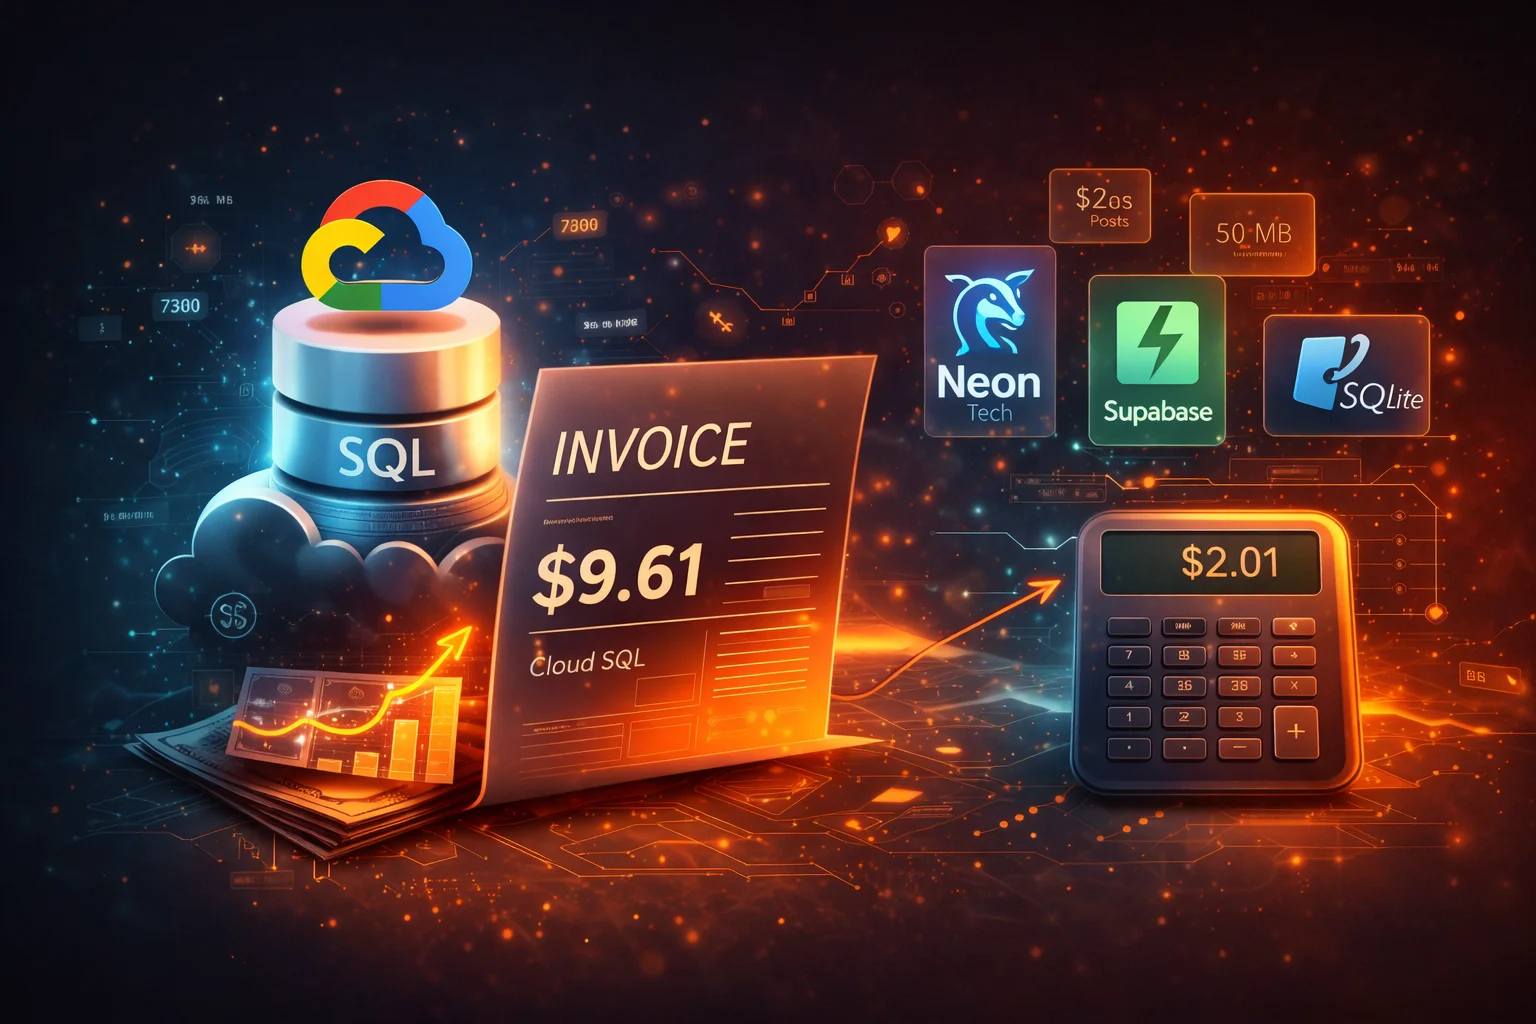
Este artículo técnico revela la verdad oculta sobre los costos de Cloud SQL, especialmente cuando se utiliza para proyectos pequeños. Explica cómo, a diferencia de servicios como Cloud Run, Vertex AI y Cloud Storage que cobran por uso, Cloud SQL cobra por la instancia activa 24/7, incluso si la base de datos está casi vacía. Se analiza el desglose de costos de cada servicio en Google Cloud y se explica por qué Cloud SQL puede ser una opción costosa para aplicaciones de bajo tráfico. El lector aprenderá a identificar cuándo Cloud SQL es la opción correcta y cuándo es mejor buscar alternativas m