Este artículo describe el diseño de un DataMart para analizar datos de YouTube Analytics, resolviendo la limitación de la API al permitir el análisis histórico y de la competencia. Se utiliza la YouTube Data API v3, Django con JSONField para la capa raw y un esquema dimensional normalizado para las consultas analíticas. El lector aprenderá sobre la importancia de planificar la cuota de la API, diseñar un ETL idempotente y estructurar un DataMart en capas raw y dimensional antes de escribir el código.
¿Cómo pasar de 8 minutos a menos de 2 en un pipeline de datos con 171 hojas de Excel? En este post, analizo la migración crítica del proyecto manageDW desde dplyr hacia data.table. Exploro por qué la manipulación in-place y la gestión eficiente de memoria permitieron procesar 2 millones de filas reduciendo el consumo de RAM de 4 GB a solo 800 MB. Una comparativa técnica sobre cuándo priorizar la legibilidad de la "gramática de datos" frente al rendimiento bruto en entornos de producción.
¿Cómo lidiar con los datos censurados por confidencialidad en las estadísticas públicas? El SII de Chile utiliza asteriscos para proteger la privacidad en comunas con pocas empresas, rompiendo la coherencia jerárquica de los datos. En este post, exploramos cómo el proyecto manageDW resuelve este problema combinando la potencia predictiva de Random Forest con el rigor matemático del Iterative Proportional Fitting (IPF). Descubre cómo este algoritmo de 80 años de historia permite imputar valores faltantes asegurando que las sumas de las comunas coincidan exactamente con los totales provinciales y regionales.
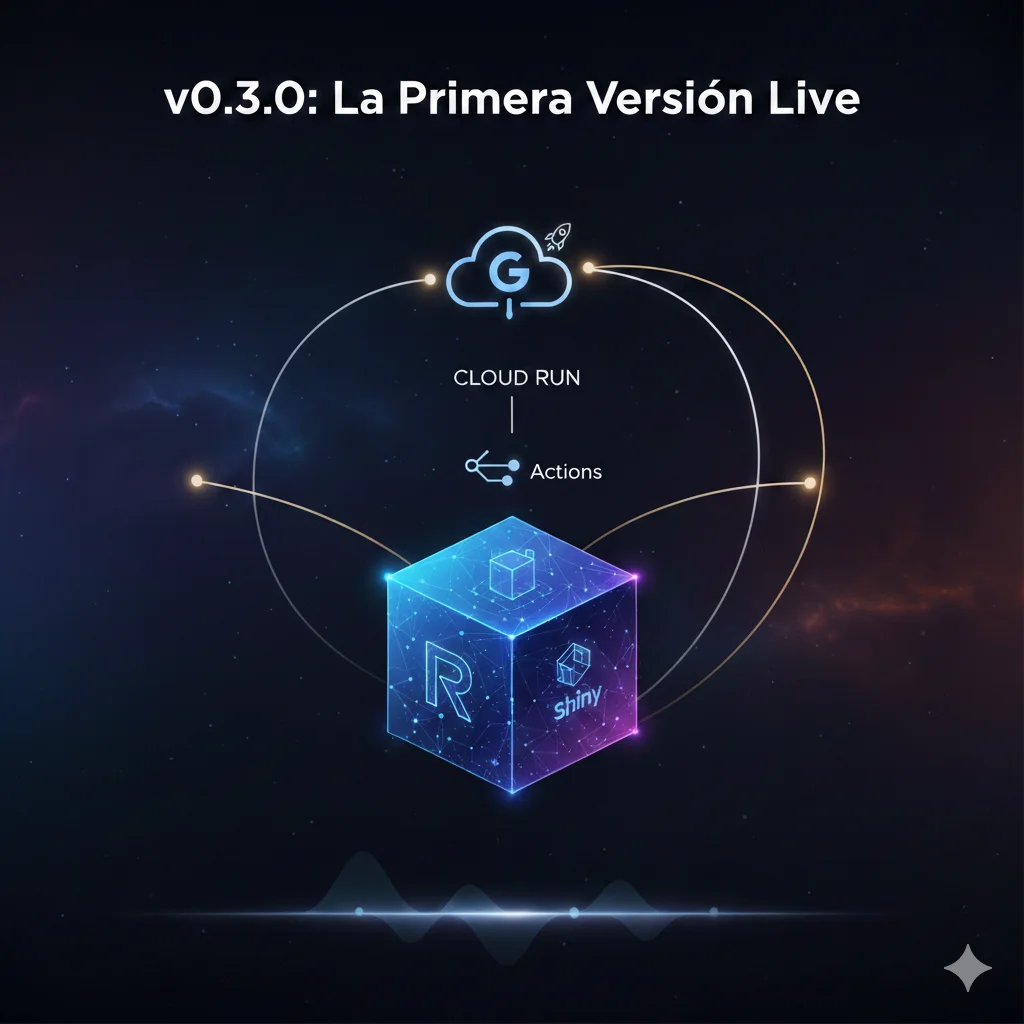
De Localhost al Mundo: Desplegando Shiny con Docker, Cloud Run y Neon.
¿Cómo pasar un dashboard de R/Shiny de localhost a una URL pública con costo casi cero? En esta guía técnica de la v0.3.0, detallo la arquitectura serverless ideal para proyectos de datos: el uso de Neon para PostgreSQL escalable a cero, la contenedorización con Docker (optimizada para geo-dependencias) y el despliegue automatizado mediante GitHub Actions en Google Cloud Run. Una solución profesional para evitar los límites de shinyapps.io y la administración de servidores VPS.
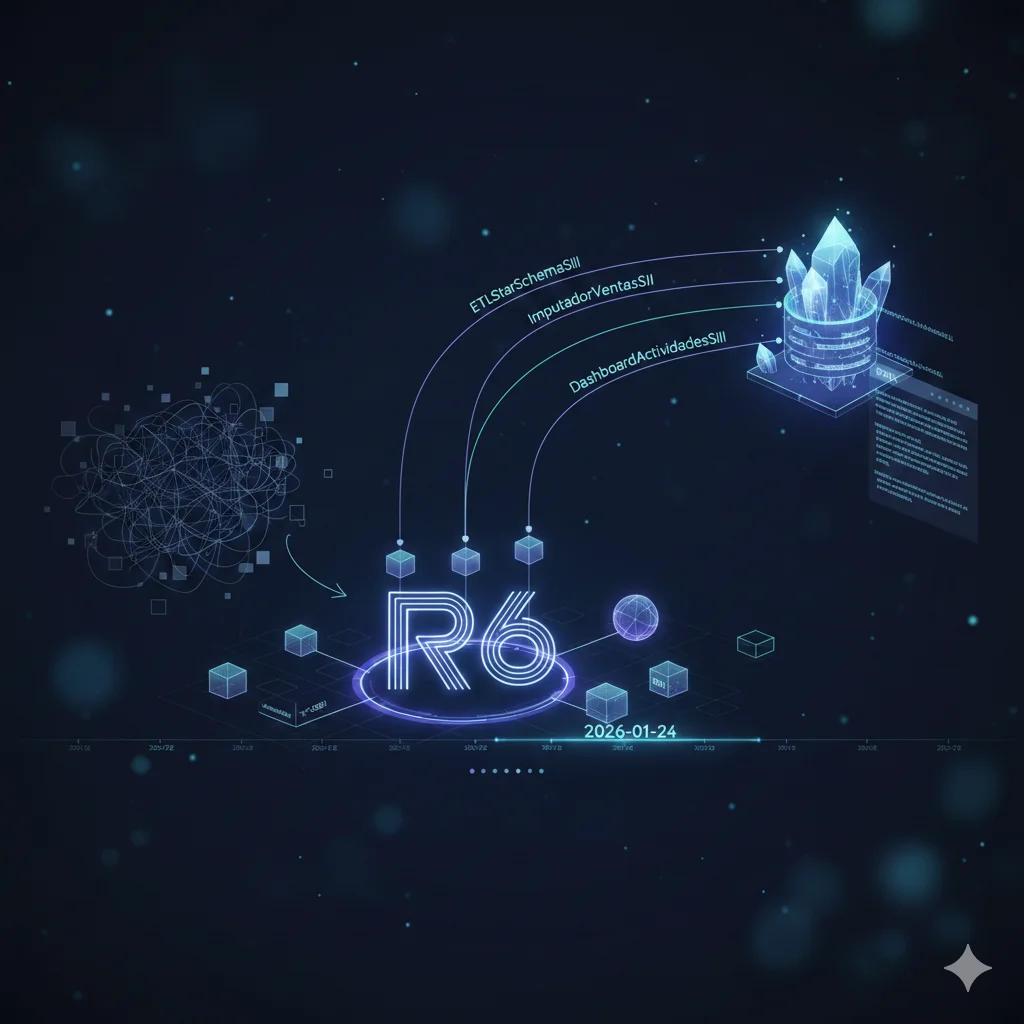
De scripts dispersos a una arquitectura profesional: La evolución de manageDW. Un análisis detallado sobre cómo la migración a un paquete de R y el uso del sistema de clases R6 transformaron un conjunto de funciones frágiles en un pipeline de datos robusto, escalable y fácil de mantener para el procesamiento de datos del SII.
Este post muestra cómo pasar de coeficientes econométricos a evidencia interpretable para política pública mediante analítica derivada pre-computada. El pipeline calcula estacionalidad de márgenes, estimaciones aproximadas de bienestar del consumidor basadas en GIRF, tests de robustez del umbral con Hansen-Seo y benchmarks cross-seccionales entre productos y regiones. Además, introduce un “embudo de validación” que verifica la integridad de cada etapa antes de generar reportes, junto con una decisión de arquitectura clave: separar completamente cálculo estadístico y presentación para lograr reportes reproducibles, rápidos y auditables.
La base pública de precios hortofrutícolas de la Oficina de Estudios y Políticas Agrarias expone millones de registros a través de CKAN, pero descargarlos íntegramente exige lidiar con paginación estricta, cambios silenciosos en el esquema y unidades de venta inconsistentes. Este post muestra cómo construir un loader robusto con reintentos y caching, normalizar presentaciones heterogéneas a $/kg y transformar los datos crudos en un star schema analítico en PostgreSQL listo para consulta masiva.
Una tesis de magíster iniciada en 2017 para estudiar la transmisión asimétrica de precios en el mercado agrícola chileno terminó, ocho años después, convertida en un pipeline reproducible de software: paquete R, base PostgreSQL, matching semántico y ejecución en la nube. Este post cuenta la evolución técnica del proyecto —de scripts académicos a ingeniería de datos— y cómo hoy permite estimar modelos TVECM en decenas de series producto-región.